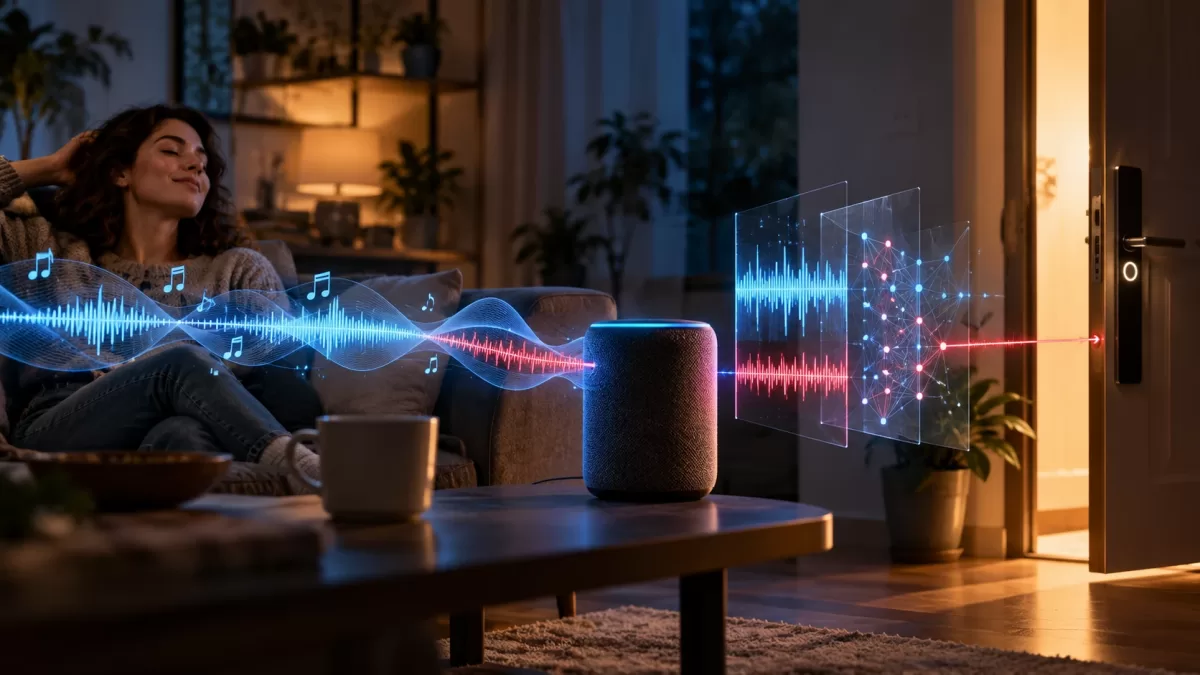
Evinizde müzik çalarken sesli asistanınızın sizin duymadığınız bir komutu algıladığını düşünün. Kötü niyetli kişiler, normal sesin içine insan kulağının ayırt edemeyeceği fakat konuşma tanıma modelini etkileyebilecek sinyaller yerleştirmeye çalışabiliyor. Bu tür saldırılar, modelin bir kapıyı açma veya başka işlem başlatma komutu duyduğu yanılgısına düşmesine neden olabilir.
George Mason Üniversitesi'nden Qiang Zeng ve doktora öğrencisi Ying Meng, bu saldırıların milyonlarca cihazda aynı anda işe yaramasını zorlaştıran DivNet adlı bir teknik geliştirdi. Yöntem 2026'daki MobiSys akademik konferansında sunuldu.
Sorunun kökünde ölçek ekonomisi bulunuyor. Üreticiler milyonlarca cihaza aynı ses tanıma modelini yerleştirebiliyor. Bu, geliştirme maliyetini düşürüyor ama saldırgan için de avantaj yaratıyor: Bir modele uygun saldırı sinyali bulunduğunda aynı modeli kullanan bütün cihazlar benzer şekilde etkilenebilir.
DivNet bu durumu değiştirmek için modelin içindeki matematiksel ağırlıkları inceliyor. Normal konuşmanın tanınması için kritik özellikleri korurken saldırı sinyallerine verilen tepkiyi etkileyen ağırlıklarda çok küçük değişiklikler yapıyor. Böylece birbirine benzeyen ama güvenlik bakımından aynı davranmayan çok sayıda model sürümü oluşuyor.
Kullanıcının açıkça söylediği 'ışığı aç' gibi bir komut farklı cihazlarda anlaşılmaya devam edebilir. Buna karşılık saldırganın bir cihaz için hazırladığı gizli komutun başka bir cihazı da kandırması zorlaşır. Üretici, milyonlarca modeli baştan eğitmek zorunda kalmadan farklı varyasyonlar dağıtabilir.
Araştırmacılar yöntemin devasa sayıda sürüm üretmeye elverişli olduğunu ve yeni bir varyasyonun ilk hesaplamalar tamamlandıktan sonra çok kısa sürede hazırlanabildiğini bildiriyor. Testlerde bazı saldırıların başarı oranı belirgin şekilde azalırken sıradan konuşmayı tanıma becerisinde sınırlı değişiklik görüldü.
Bu yöntem tek bir cihazı tamamen saldırıdan muaf hale getirmiyor. Başarı, aynı saldırının büyük cihaz gruplarına kolayca yayılmasını önlemekte. DivNet'in haber değeri, yapay zekâ güvenliğini yalnızca 'tek modeli daha iyi koruma' sorunu olarak değil, cihaz çeşitliliği ve ortak zayıflıkları azaltma meselesi olarak ele alması.